《如果讓果蠅學會打 LoL?我真的把果蠅神經網路接上了英雄聯盟》
文章摘要:如果有一天,我們不再使用 Transformer、CNN 或一般的強化學習神經網路,而是直接拿一套真實生物的神經連接結構來控制遊戲角色,會發生什麼事?
如何打造一隻會打 LoL 的「果蠅」:從虛擬複眼到 MaleCNS 神經控制器
本文記錄 FlyLoL 的工程設計與實驗思路:讓一個受果蠅視覺啟發的控制器,透過螢幕像素、神經網路與 reward feedback,在 MuMu 的 Wild Rift practice/custom 環境中完成移動、攻擊與基本戰術決策。
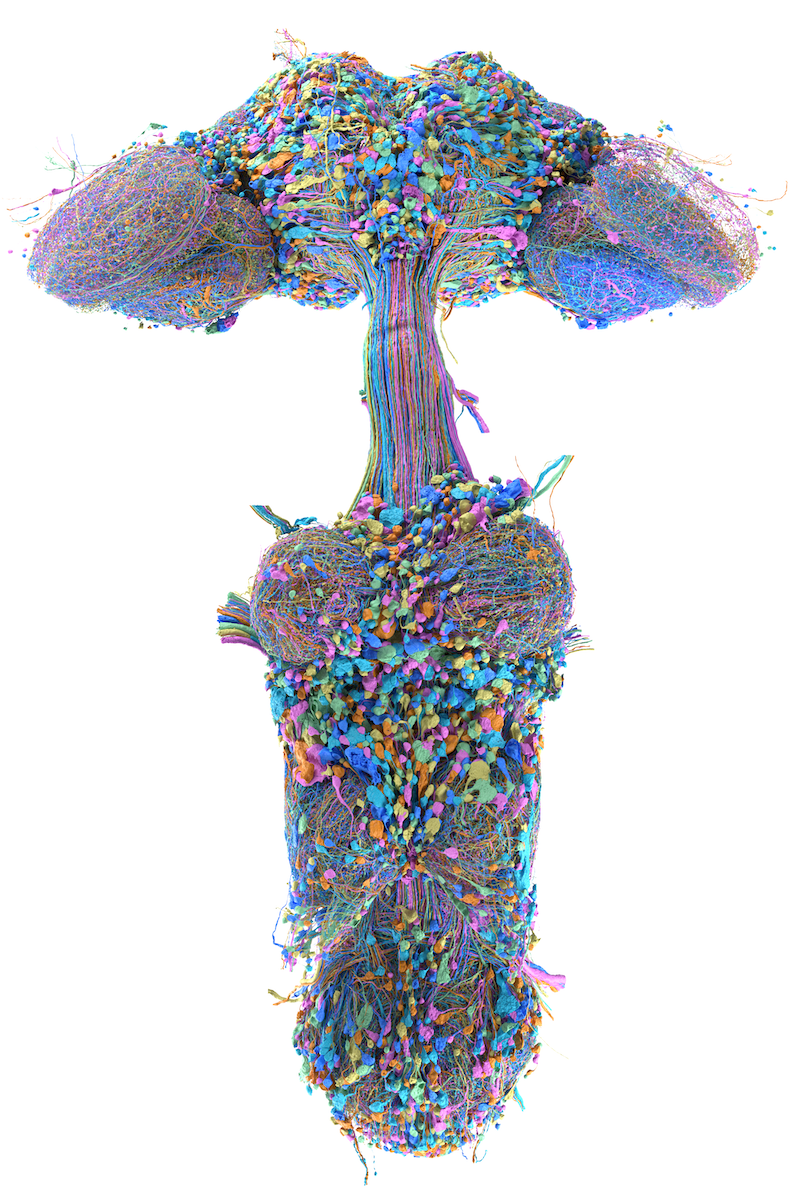
拜Google大神所賜,最近網路上火紅的Google將整隻果蠅的神經大腦傳導系統整個數位化並大方的開源給大家使用與研究,網路上開始一堆大神開發的果蠅各式各樣的操作,這兩週已經有人把這套 connectome 接到 Doom、Super Mario 64、Beat Saber、Minecraft,甚至拿去做交易實驗,我看了這些報導後也想來嘗試看看,畢竟AI結合使用研究網路開源專案的速度很快,這也是科技發展到現在一件不可思議的地方。
最重要的是這幾個入口。
官方 Google Research 公告:
https://www.research.google/blog/a-connectomics-milestone-mapping-the-complete-male-fruit-fly-brain/
MaleCNS 官方專案:
真正下載資料:
https://male-cns.janelia.org/download/
github上專案:
https://github.com/natverse/malecns

一、為什麼要讓果蠅打 LoL?
「果蠅打 LoL」聽起來像一個玩笑,但它其實是一個很好的工程問題:如果不讓控制器直接取得遊戲狀態、角色座標或內部數值,只給它螢幕畫面,它能不能從有限的視覺資訊產生可用的行為?
這個問題同時包含三個挑戰:
- 視覺壓縮:完整遊戲畫面資訊量太大,需要轉換成簡單、可解釋的感官輸入。
- 神經決策:感官輸入要經過一個具有時間狀態的 network,而不是單幀規則判斷。
- 行為閉環:控制器送出動作後,必須從下一幀畫面確認結果,才能決定是否繼續、修正或撤退。
因此,這個專案不是單純把一個模型接到遊戲按鍵,而是嘗試建立一條完整的 closed loop:
螢幕像素 → 虛擬複眼 → MaleCNS graph → 行為與安全層 → 遊戲輸入 → 新畫面
但要注意!!LoL官方並不允許外掛行為玩遊戲(其實大部份遊戲都有類似的條款),使用外掛是會被凍結帳號的。所以本專案只是研究性質,且在訓練模式下測試的,事實上果蠅操作的角色逃跑比打怪強,不知道是不是我用出了一隻膽小果蠅的關係 哈~
二、這不是完整的果蠅大腦
先釐清專案的定位非常重要。
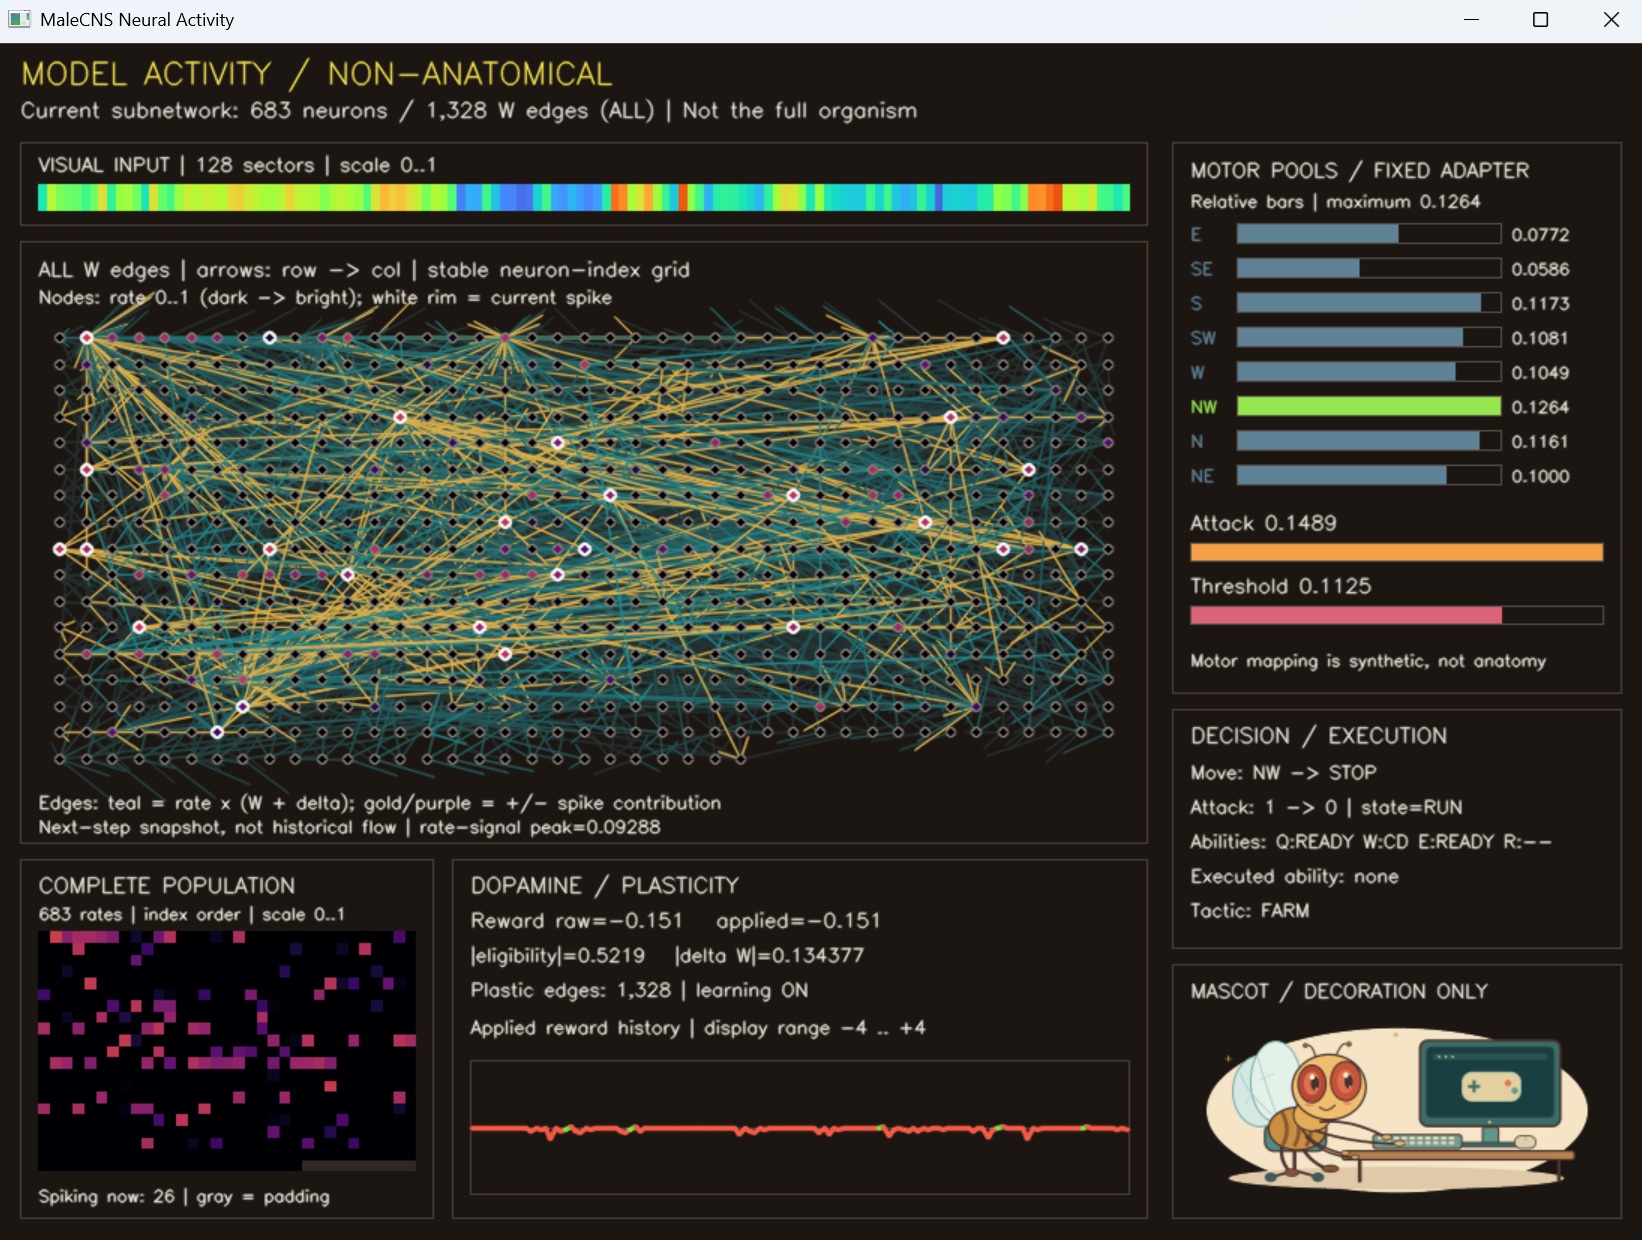
這個「果蠅」是工程比喻,不代表專案已經重建完整的果蠅大腦,也不代表所有行為都具有生物學上的等價性。目前使用的 MaleCNS cache 是一個 683 neurons、1,328 edges 的子網路,而不是完整腦部或 whole-body nervous system。
系統中有幾個明確的工程元件:
- 128-sector virtual compound eye。
- sector 到 visual neuron 的 synthetic mapping。
- LIF-style neural dynamics。
- neural activity 到 movement/attack 的 readout。
- Garen tactics 與 safety gate。
- MuMu 螢幕擷取與輸入 adapter。
這些設計讓系統可以執行與測試,但不能把它們包裝成已驗證的生物神經迴路。這種界線反而很重要,因為只有先分清楚「真實資料」與「工程假設」,後續實驗才有辦法被重現與比較。
三、第一層:把遊戲畫面變成 128 格複眼
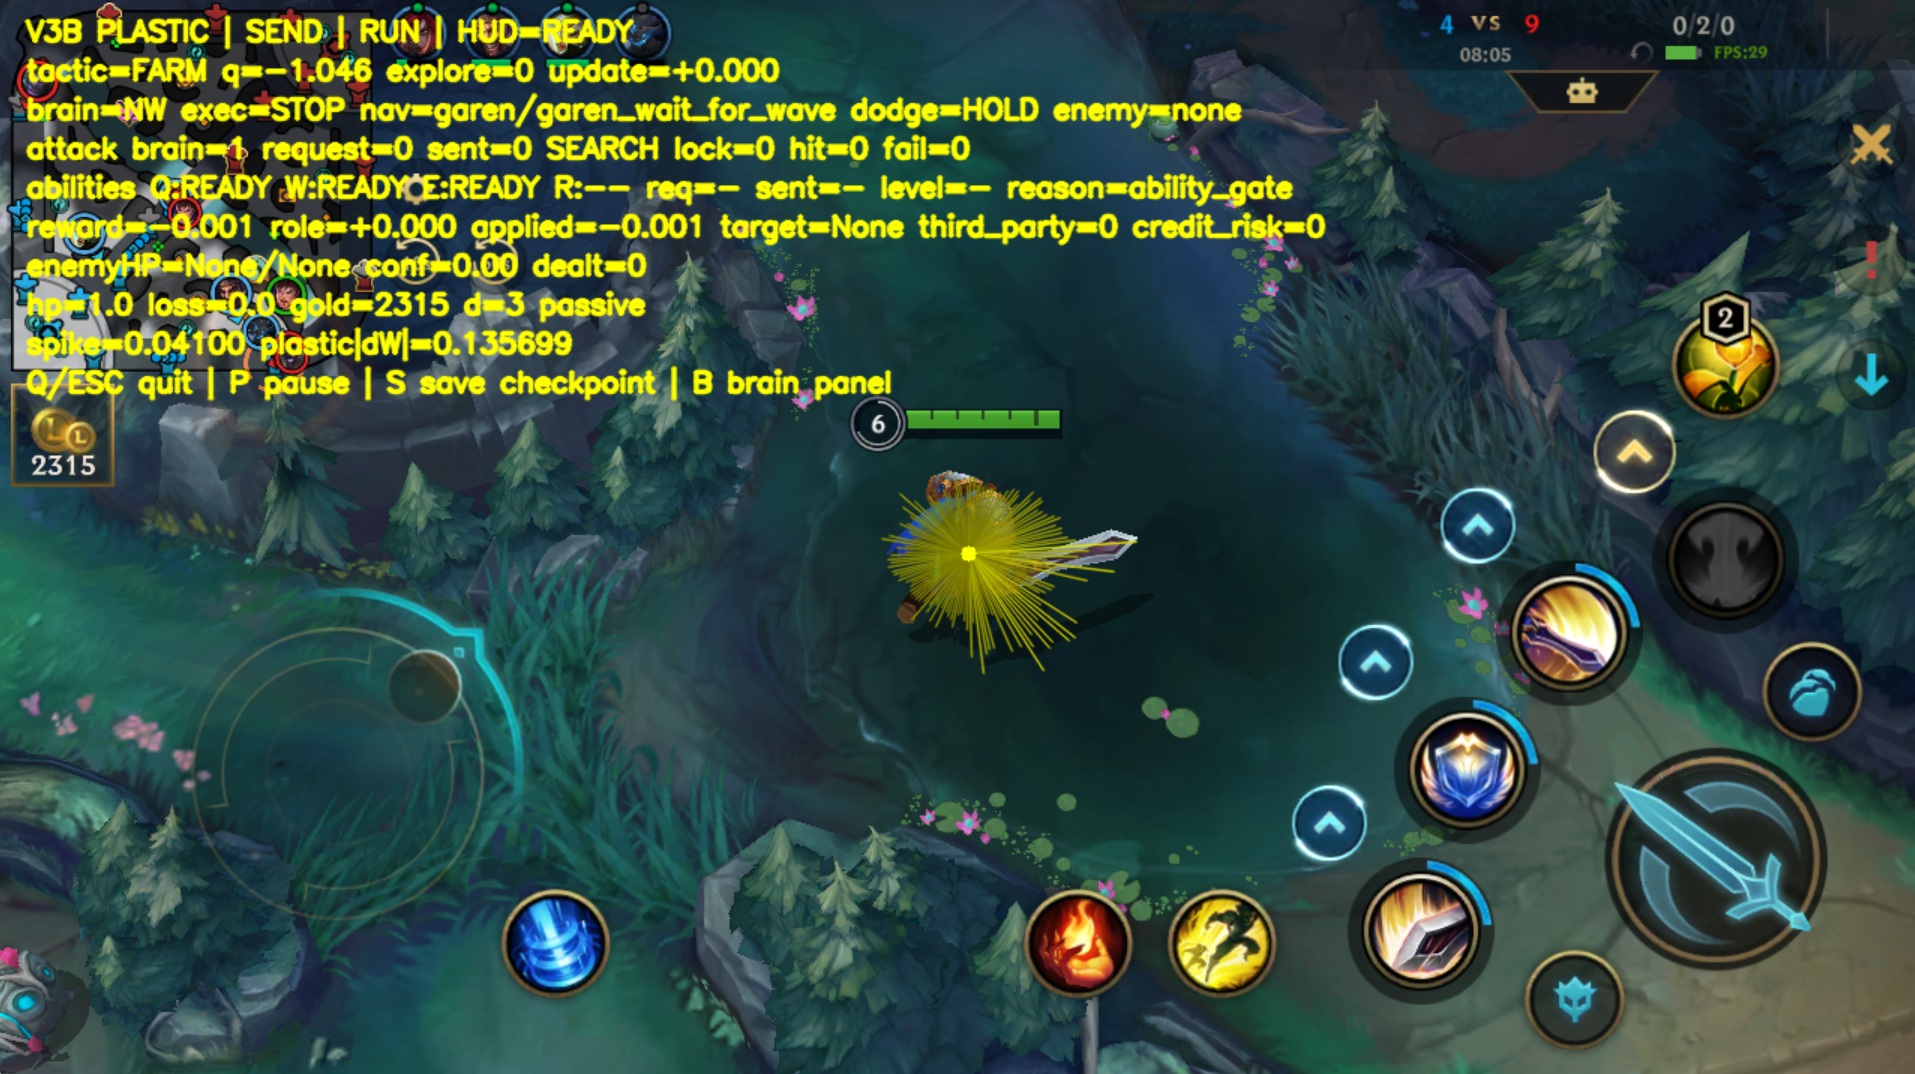
FlyLoL 不把完整 RGB 畫面直接送進神經網路。MuMu 透過 ADB 擷取 framebuffer,接著以校準好的 champion center 為中心,建立 128 個環形視覺 sector,並使用多個 ring 表示不同距離的刺激。
MuMu Wild Rift
      │
      ▼
ADB screenshot
      │
      ▼
128-sector virtual compound eye
      │
      ├─ visual stimulus
      ├─ target and enemy cues
      └─ confidence / safety signals
這種表示法的優點是簡單而且容易觀察。預覽模式會直接把 sector 畫回畫面,亮度越高代表該方向的刺激越強:
python app.py preview
如果畫面縮放、HUD 位置或 MuMu 視窗配置改變,必須重新校準:
python app.py calibrate
python app.py calibrate-abilities
校準內容包括角色中心、虛擬搖桿、攻擊按鈕、玩家 HP bar、gold counter,以及 Garen 的 Q/W/E/R 位置。
四、第二層:從 MaleCNS graph 讀出行為
V2 graph cache 保存 MaleCNS 的 body IDs、連線與 connection weights。V3B 載入這個固定的 biological-connectome prior,再讓一部分既有 edge 擁有可學習的 plastic component:
w_eff = w_malecns + delta_w_plastic
在每次控制步驟中,系統會:
- 將 128 格視覺刺激映射到 visual cells。
- 執行多次 neural integration step。
- 更新 neuron membrane state、spikes 與 firing rate。
- 計算 8 個 movement pools 與 attack pool 的分數。
- 產生移動方向與攻擊請求。
- 依照 reward 和 eligibility trace 更新
delta_w_plastic。
這裡的關鍵不是讓神經網路直接輸出一個完美答案,而是保留時間動力學:同一個畫面在不同內部狀態下,可能產生不同的決策;先前的活動也可能影響下一個控制步驟。
在正式接遊戲之前,可以先執行本地 2D demo:
python main.py --brain demo
這個 demo 有一隻黃色果蠅、綠色食物和障礙物,右側 panel 會顯示 action、reward、視覺 sector 與 neural readout。它的目的不是模擬 LoL,而是先驗證「看見目標 → 產生方向 → 移動 → 得到 reward」這條 pipeline。
五、第三層:用 tactical layer 把神經活動變成遊戲行為
單靠 movement readout 不足以讓角色穩定打線。遊戲中的「要不要靠近」、「要不要攻擊」和「什麼時候撤退」需要另一層可觀測的行為狀態。
目前 Garen solo profile 使用幾個主要 tactical actions:
- FARM:優先尋找處於 last-hit HP band 的 minion。
- SHORT_TRADE:在安全距離接近英雄,嘗試一次短換血。
- PRESSURE:只有在 HP 有優勢時維持接近與側向壓力。
- ALL_IN:敵方低血且自己仍高於安全線時才追擊。
- DISENGAGE:受到傷害、血量過低或目標消失時撤退。
這些狀態不是讓 AI 直接變成人類玩家,而是把錯誤邊界寫清楚。舉例來說,低血量時即使 exploration 想嘗試 ALL_IN,也不能越過 hard safety gate。
同樣的原則也用在攻擊結果:送出一次 J 之後,系統進入 WAIT_RESULT,必須等到目標 HP、HP bar 或其他可觀測證據確認結果,才會允許下一次攻擊。這能避免控制器因為沒有收到回饋,而在固定 cooldown 上盲目連點。
六、Garen Q/W/E/R 的安全設計
技能控制使用校準後的 touchscreen coordinates,但技能並不是看到 icon 變亮就直接點擊。
- Q:只在已批准的進攻情境中使用,並把下一次普攻標記為 Q-enhanced attack。
- W:主要作為防禦技能,在確認受到傷害或低血量且附近有英雄時使用。
- E:要求近距離且安全的英雄鎖定,啟動期間會暫停會取消旋轉的普攻。
- R:必須已通過 ALL_IN safety gate、敵人 HP 低於 execute threshold、距離合適,且近期沒有新傷害。
這些限制的目標不是追求最積極的輸出,而是先降低不可逆的錯誤輸入。對仍在驗證階段的視覺控制器而言,「不亂按」通常比「偶爾打出漂亮 combo」更有價值。
七、Reward 不只是分數,而是事件歸因
如果只用畫面上的單一 heuristic 當 reward,很容易把錯誤歸因當成學習訊號。例如 gold 增加可能是 passive income,也可能是補刀;敵方掉血可能是自己造成,也可能是 friendly minion 或隊友造成。
因此 reward extractor 將觀測拆成幾類事件:
- step cost。
- 玩家受到傷害。
- death penalty。
- 可歸因的 enemy damage。
- last-hit/CS candidate。
- favorable 或 unfavorable trade。
- failed attack timeout。
- successful disengage。
一個重要例子是 CS:只有在近期確實送出攻擊、gold delta 通過條件檢查,並排除 passive income 後,才會將它分類為 last-hit reward。附近存在 friendly hero 或 minion 時,系統會提高 damage attribution risk,避免直接把所有掉血都算給自己。
這些事件與原始訊號會寫入 logs/session_*.csv,讓實驗可以回頭檢查,而不是只依賴影片中一個看起來成功的片段。
八、如何驗證它真的有進步?
最簡單的比較是使用相同起始 checkpoint,執行 plasticity ON 與 OFF 兩組 session:
python app.py run --plasticity off
另一組則使用預設的 plasticity enabled 設定。比較時可以觀察:
- reward trend。
- CS proxy。
- death 次數。
- successful disengage 次數。
- attack timeout。
- firing rate。
plastic_abs_mean。- tactical value updates。
但要小心,plastic_abs_mean 增加不等於行為一定變好;它只代表 learned delta 正在改變。真正有意義的指標,應該是相同測試條件下的行為結果是否穩定改善。
同樣地,一次成功擊殺也不能證明 controller 已經學會 LoL。比較可靠的做法是固定起始條件、增加 session 數量、保留完整 CSV,並將成功與失敗事件都納入分析。
九、從 dry-run 開始,而不是直接送輸入
這個專案的 run 預設是 dry-run:它會擷取畫面、執行視覺與神經決策,但不會送出遊戲輸入。建議流程如下:
python app.py doctor
python app.py preview
python app.py run --control-hz 2
只有在方向、座標與 safety signals 都確認正確後,才在自己的 practice/custom 環境明確啟用輸入:
python app.py run --control-hz 2 --send-input --input-backend adb --fresh
若使用 virtual gamepad backend,則可以改用:
python app.py run --control-hz 2 --send-input --input-backend gamepad
這個專案不包含 anti-cheat bypass、process-memory access、packet interception 或 matchmaking automation。所有測試都應該留在自己的隔離環境與允許的 practice/custom session。
十、目前的限制與下一步
目前已經能夠展示的,是一條可以觀察與記錄的 closed loop:
像素 → 虛擬複眼 → neural activity → tactical decision → input → reward
但仍有幾個不能忽略的限制:
- 128-sector eye 是工程化的視覺壓縮,不是完整的果蠅眼部解剖模型。
- MaleCNS cache 是有限子網路,沒有涵蓋完整的 nervous system。
- motor projection、movement pools 與 attack pool 是 synthetic engineering components。
- 部分技能與傷害結果仍需要更多 live-session 與 replay fixture 驗證。
- 目前還不具備可靠的牆後路徑規劃、完整 projectile dodge 或高階 macro strategy。
- kill detector 與 turret damage detector 在尚未完成驗證前,不應被當成可靠 reward。
下一步最值得做的,不一定是加大模型,而是增加可重現的 replay fixture,驗證 target identity、技能 ready state、傷害 attribution、死亡/重生與 dodge boundary。當每個失敗都能被定位,學習結果才有機會真正被比較。
結語:從「會動」到「少犯同一個錯」
打造一隻會打 LoL 的果蠅,真正有趣的地方不在於它能不能打出一場人類級比賽,而在於如何把一個看似荒謬的目標拆成可測試的工程問題:
- 它能不能從像素中抽取簡單視覺刺激?
- 神經網路能不能把刺激轉成方向?
- 控制器能不能等待動作結果,而不是盲目重試?
- reward 能不能正確歸因?
- plasticity 是否讓相同情境下的行為逐漸改變?
目前的 FlyLoL 還不是一個真正理解 LoL 的果蠅,但它已經把「看見」、「決策」、「輸入」和「學習」串成一個可觀測的實驗系統。下一個里程碑不是一次偶然的 highlight,而是在相同條件下,它能不能少犯一個同樣的錯。
我的專案網址: