8GB VRAM 筆電也能跑大模型:Strata × Qwen3.8-Flash-Next IQ3_S,打造 128K 本機 Coding 服務
文章摘要:RTX 4070 Laptop 8GB VRAM+32GB RAM,透過 Strata、Q4 KV 與 SSD experts 執行 Qwen3.8-Flash-Next abliterated IQ3_S。…
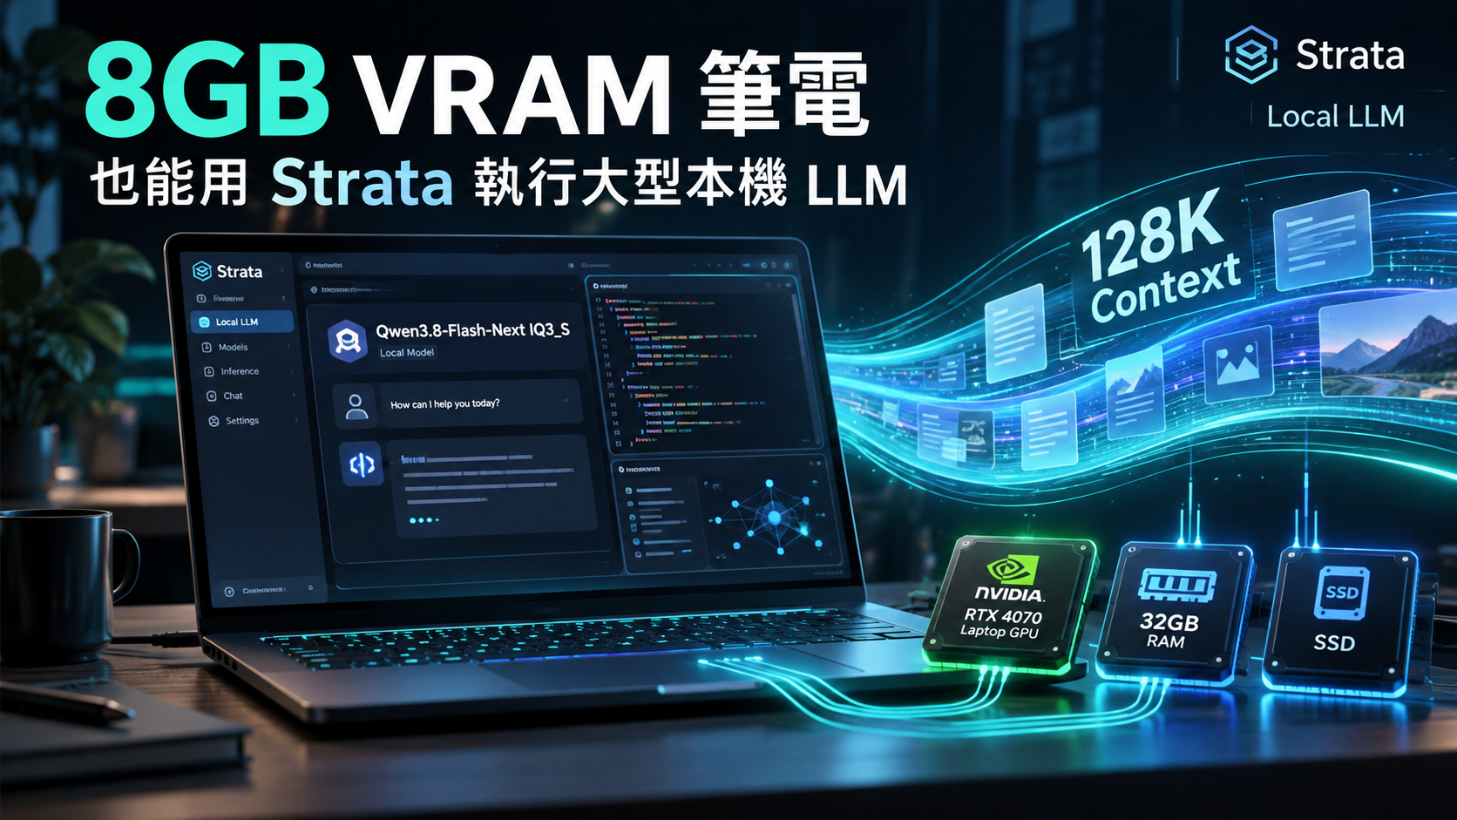
8GB VRAM 的筆電,不代表只能跑小模型。這次的主角是 NVIDIA GeForce RTX 4070 Laptop GPU(8GB VRAM)+32GB RAM,搭配 Strata,在本機提供 Qwen3.8-Flash-Next abliterated IQ3_S 的推論服務,將 context window 設為 131072 tokens,也就是 128K,讓 coding agent 有機會保留更長的專案脈絡。
日常使用回報約落在 2.5–10 token/s;這是有條件的體感區間,不是保證下限。本次實際截圖能看到約 7.7 tok/s,以及約 93K prompt 的請求紀錄。重點不是宣稱筆電可以取代雲端旗艦,而是:在願意用 SSD、RAM 與等待時間換取容量的前提下,這套配置已經有作為本機 coding 助手的實用空間。
先講清楚三件事:128K 是服務設定與 API 回報的容量,不代表填滿後仍維持相同速度;2.5–10 t/s 不能當作各種任務的 SLA;大模型能執行,不等於模型權重全部放得進 8GB VRAM。
一、這次實際使用的硬體、模型與版本
| 項目 | 本次確認的內容 |
|---|---|
| 作業系統 | Windows 11 |
| CPU | Intel Core i7-14650HX,16 cores/24 threads |
| GPU | NVIDIA GeForce RTX 4070 Laptop GPU,nvidia-smi 回報 8188 MiB |
| RAM | 標稱 32GB,系統回報約 31.67 GiB |
| 安裝與設定 | D:Strata;主 profile 為 strata-iq3_s.json |
| 模型 | SC117/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-GGUF,IQ3_S 版本 |
| 服務模型名稱 | qwen3.8-flash-next-abliterated-iq3_s |
| 目前服務引擎 | /props 回報 Strata 0.1.55;後面的歷史調校數字來自 0.1.52,不混為同一輪 benchmark |
| Context window | 131072 tokens;輸入、system prompt、tools、歷史與輸出共用容量 |
模型頁列出的總參數量為 177B;這不是「177B dense 模型全塞進顯卡」。該頁未提供足以在這裡引用的 active-parameter 數字,因此不另外猜測。
IQ3_S 原始 GGUF 有兩個分片,本機檔案大小分別約 55.06GB 與 28.80GB,合計 83.86GB(約 78.10GiB)。Strata 準備的 pack、MTP、視覺檔與快取還會占額外空間,不能只預留原始下載大小。
二、為什麼 8GB VRAM+32GB RAM 還跑得動?
這組配置的核心是量化、分層記憶體與從磁碟讀取 experts,不是把硬體限制變不見。針對這份本機 profile,可以看到:
- IQ3_S:降低模型儲存成本,但仍需要大量 SSD 空間;量化也可能影響品質。
--mmap-experts:專家資料透過檔案映射,由 SSD/RAM/Windows 檔案快取參與供應;讀取不在快取裡的資料仍有 I/O 成本。- Q4 KV+KV streaming:
--max-context 131072 --kv q4_0 --kv-resident 32768,將總視窗與 GPU 常駐的 KV 容量分開。 - MTP drafting:使用準備好的 MTP 資料嘗試加速生成;收益取決於草稿接受率,並非每輪都能等比例加速。
- 保留 VRAM 與 CPU workers:本機設定為 700 MiB VRAM reserve、13 workers,這是此機器的調校結果,不是所有筆電的最佳值。
32768 是 GPU 常駐的 KV 容量,不是把整個服務限制成 32K。但總視窗拉長後,記憶體、SSD、prefill 與 cache 行為都會影響等待時間;不能把容量和速度當成同一個指標。
三、Start-Strata-128K.cmd:把模型變成 coding agent 能連的本機服務
我更看重這個入口:不綁定特定聊天介面,讓開發工具透過本機 API 使用同一個模型。這次檢查到的啟動檔內容很簡單:
@echo off
call "%~dp0strata.cmd" serve --profile "%~dp0strata-iq3_s.json"
if errorlevel 1 pause
在 PowerShell 執行:
cd D:Strata
.Start-Strata-128K.cmd
等服務顯示 ready,再開啟 http://127.0.0.1:8080/ 使用網頁 Chat/Monitor,或從其他工具連線。本次檢查時,這個啟動檔原本已在執行,因此沿用現有服務,沒有為了截圖再啟動第二份模型。
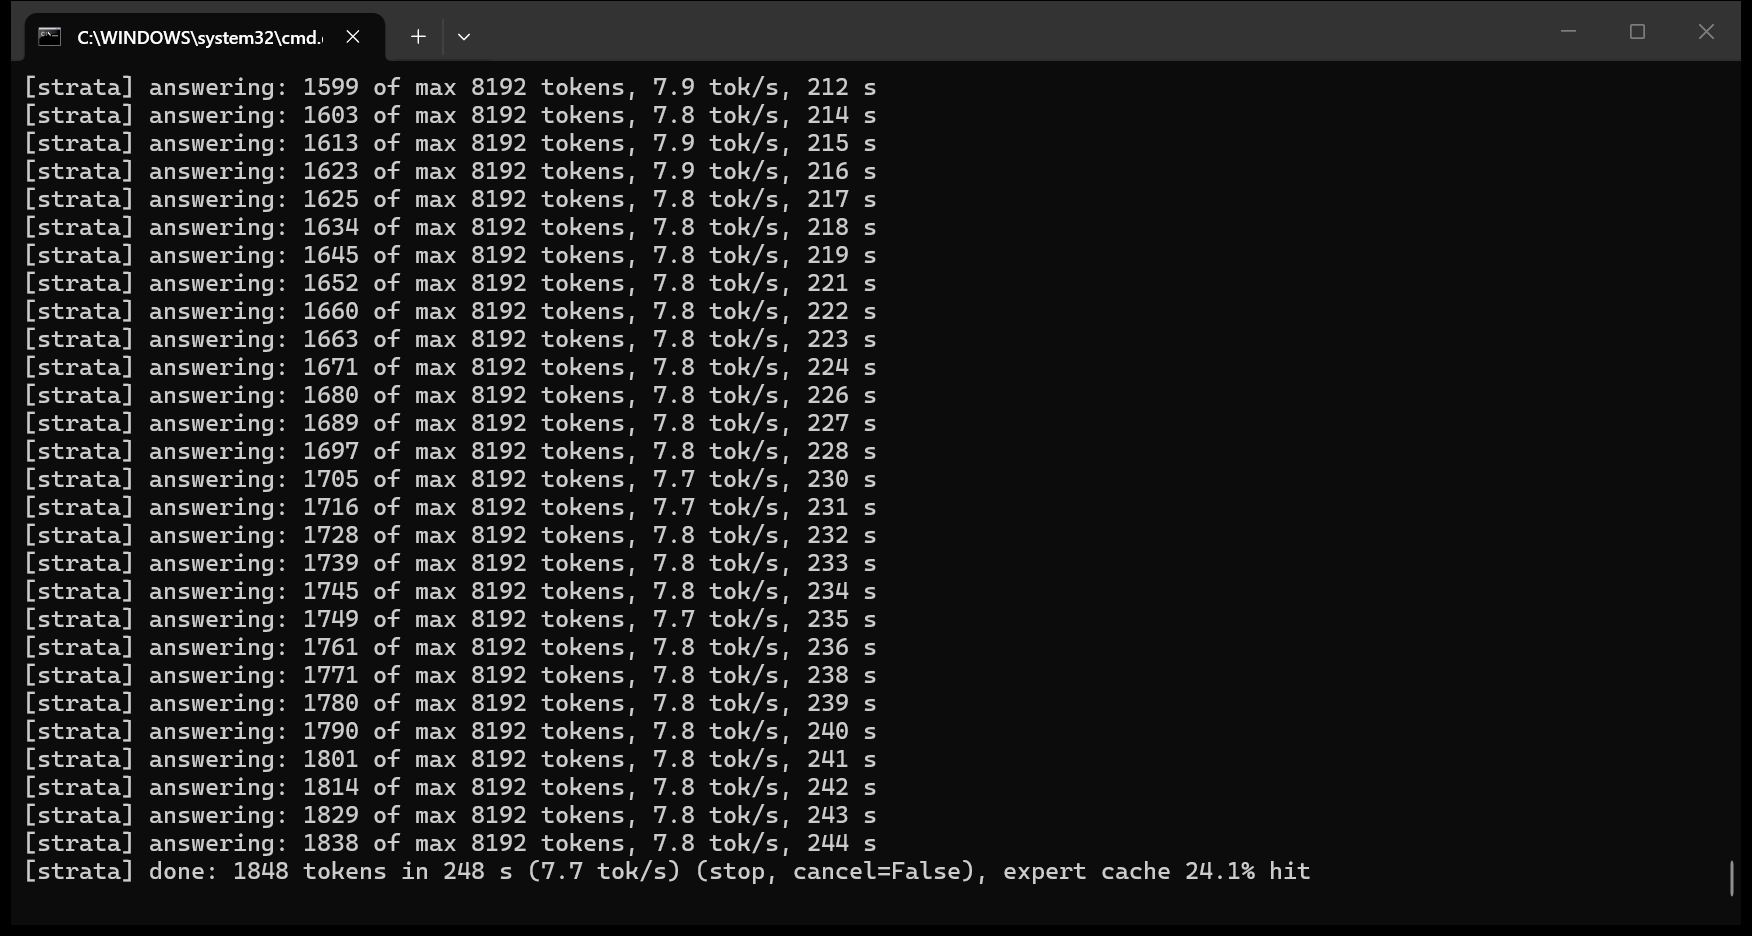
實際截圖|原本已由 Start-Strata-128K.cmd 啟動的服務;終端記錄顯示 1848 tokens、約 7.7 tok/s。沒有重複載入第二份模型。
API 的基本欄位如下:
| 欄位 | 值 |
|---|---|
| OpenAI-compatible Base URL | http://127.0.0.1:8080/v1 |
| Chat endpoint | http://127.0.0.1:8080/v1/chat/completions |
| Model | qwen3.8-flash-next-abliterated-iq3_s |
| Context | 131072 |
| API key | 本機服務未啟用驗證;客戶端必填時可用占位字串 strata-local,這不是憑證 |
| 並行 | parallel: 1,不應期待多個 agent 同時生成而完全不排隊 |
可用以下命令自行確認:
curl.exe http://127.0.0.1:8080/health
curl.exe http://127.0.0.1:8080/v1/models
本次 /health 實際回報 status: ok、loaded: true、max_context: 131072;/v1/models 也回報同一模型與 n_ctx: 131072。
四、把 D:Strata 的設定當範本:先理解參數,再複製
以下是這次 strata-iq3_s.json 的重點片段,不是可以單獨啟動的完整 profile。完整檔案還有 pack、原始 GGUF 分片、expert profile、tokenizer 與 MTP 路徑,必須先由 Strata 準備好;不要只下載 GGUF 再把這段直接貼上就期待成功。
{
  "backend": "cuda",
  "model_name": "qwen3.8-flash-next-abliterated-iq3_s",
  "host": "127.0.0.1",
  "port": 8080,
  "parallel": 1,
  "args": [
    "--max-context", "131072",
    "--kv", "q4_0",
    "--kv-resident", "32768",
    "--mmap-experts",
    "--expert-cache", "auto",
    "--prefill", "auto",
    "--spec", "4",
    "--mtp", "D:Stratamodel-datamtp
t",
    "--pool-workers", "13",
    "--prefill-head-alias",
    "--short-read", "0",
    "--spec-min-p", "0.7",
    "--vram-reserve-mib", "700"
  ]
}
這台還有 CPU 視覺編碼器與 BF16 mmproj,不占用同等的 GPU 視覺推論資源,但仍會占 RAM/CPU。本文聚焦 coding 的文字工作流,不把視覺能力列為這次重新完成的測試。
如果是從零開始,建議先從 Strata Releases 安裝符合平台的版本,依官方 strata launch 流程下載/匯入模型並準備資料,再調整 profile。本文的兩個 128K 啟動檔是這台機器的本機入口,不是上游保證每個安裝都附帶的檔案。
五、接上 coding agent:先把 URL、模型與容量對齊
Strata 提供 OpenAI/Anthropic-compatible API,也附有 strata connect。這次實際預覽了 OpenCode 的連線設定;以下命令只顯示設定,不會改寫現有客戶端檔案:
cd D:Strata
.strata.cmd connect opencode --url http://127.0.0.1:8080 --model qwen3.8-flash-next-abliterated-iq3_s --context 128k
預覽結果的重點是:
baseURL: http://127.0.0.1:8080/v1
model: qwen3.8-flash-next-abliterated-iq3_s
limit.context: 131072
limit.input: 126976
limit.output: 4096
保留 4096 tokens 給輸出,並啟用 compaction,避免輸入與輸出相加超過服務容量。實際要寫入設定時才加上 --write,先檢查產生內容與備份,再讓工具修改檔案。不要為了使用本機模型,就順便關掉 coding agent 的權限詢問與 sandbox。
若使用其他 client,請確認支援該 API dialect、tool calling 與串流。本次完成的是 API 狀態確認與連線設定預覽,不是重新跑過每一套 agent 的完整改碼/測試循環。本機既有的 function-calling 驗證紀錄有成功回傳 echo(value="strata-128k"),但一個工具呼叫成功,也不等於長任務一定可靠。
需要逐字看到答案,記得開 SSE
建立 stream-request.json:
{
  "model": "qwen3.8-flash-next-abliterated-iq3_s",
  "messages": [
    {"role": "user", "content": "Write a Python retry function with unit tests."}
  ],
  "stream": true,
  "stream_options": {"include_usage": true},
  "reasoning_effort": "none",
  "max_tokens": 512
}
curl.exe -N -H "Content-Type: application/json" --data-binary "@stream-request.json" http://127.0.0.1:8080/v1/chat/completions
正常會逐段收到 data:,最後出現 data: [DONE]。reasoning_effort: "none" 是此安裝可用的選項,可讓正文較早出現;其他模型或引擎版本要重新確認。512 tokens 只適合連通性示範,不保證足以輸出完整實作與測試。串流改善的是可見性,不會消除 prefill、模型載入與排隊時間。
六、128K 不是只寫在設定裡:實際 Monitor 看到了什麼?
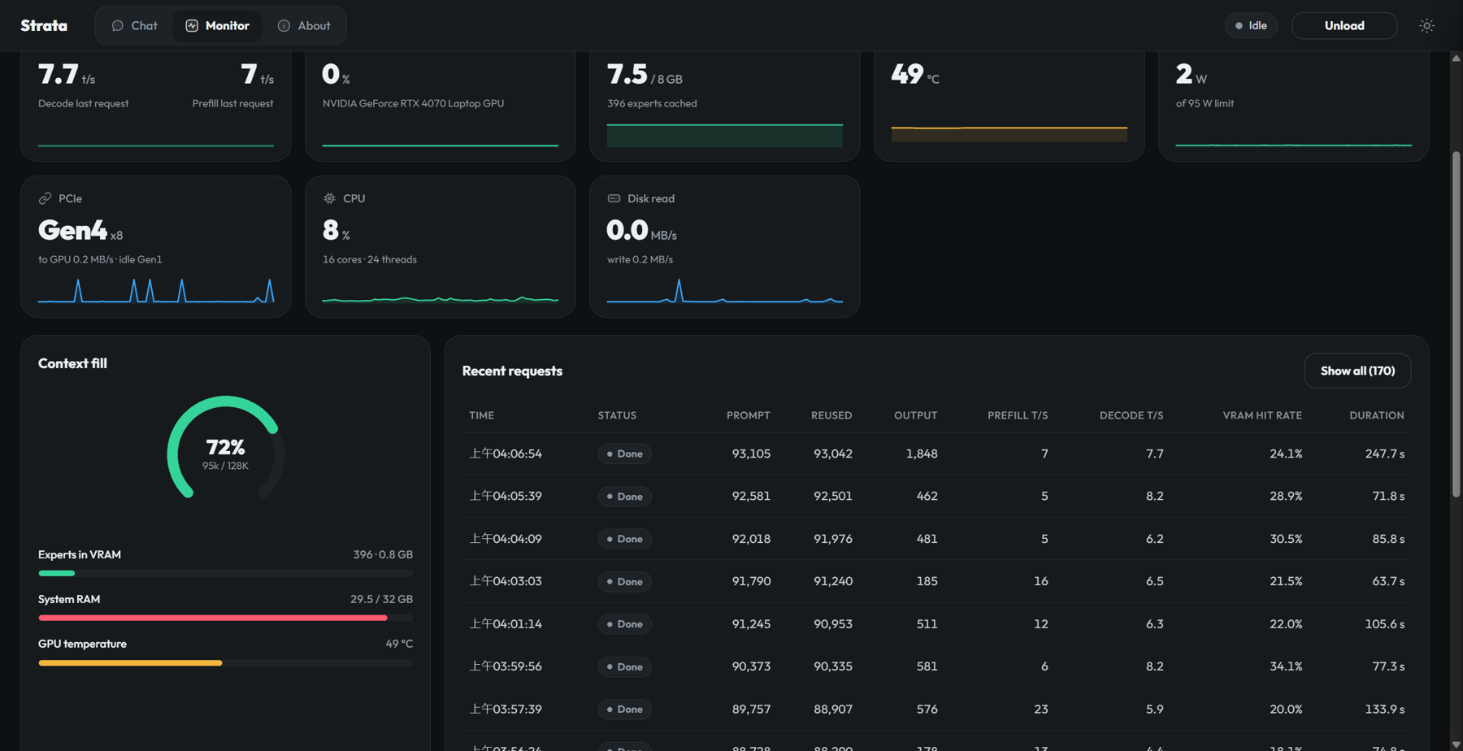
實際截圖|本機 API 的 Monitor:95K/128K context、約 7.5/8GB VRAM、約 29.5/32GB RAM;近期請求有大量 prefix cache 重用,不是從零填滿 128K 的測試。
這次擷取的 Monitor 畫面顯示:
- Context fill 約 72%,95K/128K。
- 一筆請求的 prompt 為 93105 tokens,其中 93042 tokens 被重用,新讀取部分只有 63 tokens。
- 該筆輸出 1848 tokens,decode 約 7.7 t/s,請求總時間約 247.7 秒。
- 畫面中近期多筆 decode 約 4.4–8.2 t/s;當時 VRAM 約 7.5/8GB、RAM 約 29.5/32GB。
這是長對話在高 prefix-cache reuse 下能繼續運作的實際佐證;但不能把這筆資料解讀成「從零讀取 93K prompt 只要幾秒」,也不是填滿 131072 tokens 的壓力測試。
對 coding agent 來說,128K 的價值是能攜帶更多程式碼、錯誤、測試結果與歷史決策,減少太早摘要造成的脈絡損失;真正日常使用時,仍應只帶相關檔案、重用既有前綴、及時 compaction,而不是每次都把整個 repo 重送。
七、2.5–10 token/s 要怎麼看,才不會誤會?
本文的 2.5–10 t/s 來自日常使用回報,不是這次量測出的保證範圍。除了當下截圖,D:Strataperformance 另有 2026-10-31 的原始 SSE 記錄與調校報告。下表只比較報告中同為完整配置、短提示、temperature 0、關閉 thinking、每題生成 512 tokens 的兩組結果,使用的是當時的 0.1.52 引擎:
| 測試 | 原設定 decode | 儲存調校設定後重啟 | 首段正文等待:原設定 → 調校後 |
|---|---|---|---|
| Python 程式碼與測試 | 7.7 t/s | 10.7 t/s | 6.985 → 10.734 秒 |
| SQL 說明 | 8.5 t/s | 9.1 t/s | 8.547 → 14.781 秒 |
decode 速度排除了提示處理時間。這份設定改善了這兩個短樣本的持續輸出,但首段正文反而更晚出現。SSD、Windows cache、RAM 壓力、prompt 長度、prefix reuse、MTP 接受率與筆電供電/溫度,都可能改變實際體驗。
因此,我會把它定位成可等待、可持續迭代的本機 coding 後端,適合小步改碼、補測試、分析錯誤與整理文件;不是低延遲自動補全,也不是保證所有長 context 都有 10 t/s 的服務。
八、Start-Strata-Desktop-128K.cmd:桌面入口也能使用同一份安裝
另一個入口會把安裝目錄、settings、profiles、runtime、models 與桌面資料位置指向 D:Strata,再啟動 strata-desktop.exe:
Start-Strata-Desktop-128K.cmd
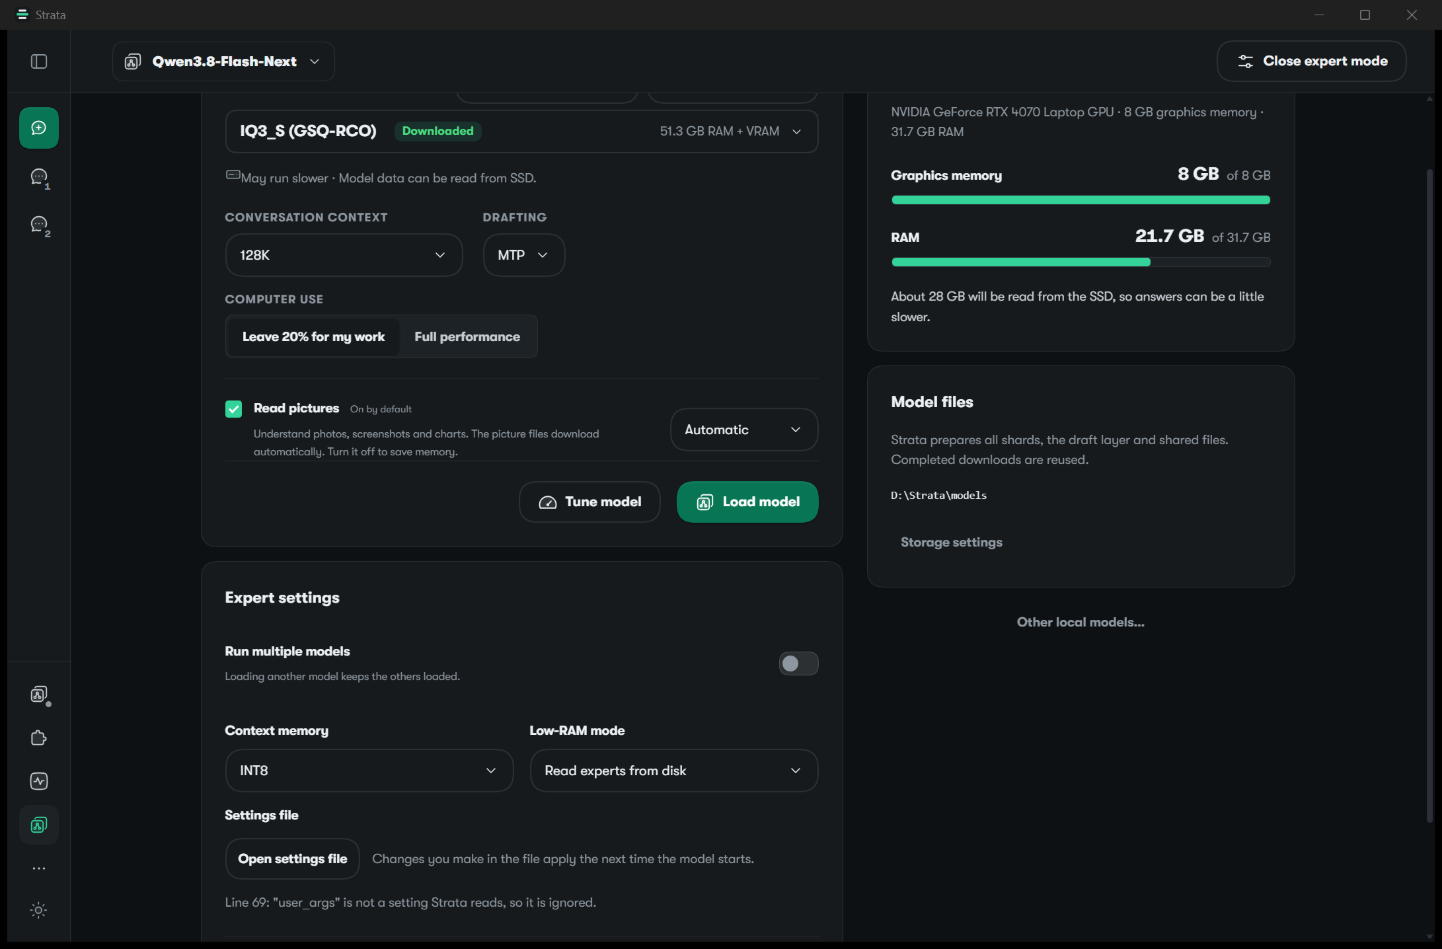
實際截圖|原生 Strata 桌面 Models 頁顯示 IQ3_S、128K、MTP 與 SSD 讀取提示;為保留既有 API,本次未在桌面按 Load model。畫面的 INT8/user_args 警告不代表獨立 API 的 Q4 設定已在桌面生效。
本次已開啟原生桌面程式並進入 Models,畫面可看到 Qwen3.8-Flash-Next、IQ3_S、128K、MTP,以及從 SSD 讀取的提示。為避免和現有 API 搶用 8GB VRAM,沒有再按 Load model,也沒有宣稱桌面版完成第二輪推論測試。要切換成桌面服務,請先在獨立 API 視窗按 Ctrl+C,確認 GPU 釋放後,再於桌面載入。
版本/介面陷阱:這次桌面設定頁的 Context memory 顯示 INT8,底部還有 user_args 警告;不能據此宣稱它已套用獨立 API 的 Q4 KV 與全部手動參數。本文可重現的 API 設定以 strata-iq3_s.json 與實際 engine 狀態為準;改用桌面載入後,應重新核對 log、context 與 KV 格式。Serving 網址和驗證方式也以該介面實際顯示為準。
九、為什麼選 abliterated「無審查」版本?讓合法測試少一點誤拒絕
外部服務一線大語言模型如: Claude or OpenAI對於使用語言模型的審查很嚴格
尤其是牽涉到資安類的開發 像是對程序做混淆等開發需求都會被阻擋 QQ [Claude opus 5.5 就阻擋我要混淆golang程式和C# NactiveAOT的需求]
對我來說,這個版本的實際價值,不是「可以不負責任地做任何事」,而是在自己擁有或獲授權的程式碼裡,減少模型只看見某些關鍵字就拒絕協助的摩擦。模型發布者以 abliteration 調整拒絕行為;它並不代表絕對不會拒答,也不代表程式能力更強。
以目前範例專案,內容包含 Go 的 HMAC 授權檢查,以及 .NET 的授權檢查、混淆與 NativeAOT 範例。這些有正當的回歸測試需求:
- Go:有效簽章、無效簽章、空值、期限邊界與大小寫正規化等案例;測試先遵循原程式契約,不偷偷改成永遠通過。
- 混淆前後:執行
--selftest,確認輸出、exit code 與外部行為維持一致。 - .NET:確認 Obfuscar、single-file、NativeAOT 不同產物仍有相同的授權判斷與錯誤處理。
- 將測試與 build 產物放在隔離的暫存/輸出目錄,避免 .NET 的來源檔 glob 意外把反編譯輸出納入編譯。
適合交給本機 coding agent 的任務,可以寫得很具體:
這是我擁有的教學用授權檢查與混淆範例。請先閱讀 README 和原始碼,只補回歸測試,不修改授權判斷、不繞過驗證。涵蓋有效/無效簽章、期限邊界與空輸入;沿用現有工具,執行最小測試並回報結果。對混淆前後的產物,比較 --selftest 輸出與 exit code,不處理任何第三方程式的授權破解。
這裡列的是根據實際專案整理的測試任務範例,本次沒有另外宣稱這些新測試已由模型產生並全部通過。較少拒答與正確答案是兩回事,生成的測試仍須人工檢查並真的執行。
模型頁也提醒這類版本缺乏可靠的內建安全防護。授權、工具權限、sandbox、資料保護與人工審查,仍要由工作流負責。本機推論可避免提示與程式碼送到雲端模型端點,但 coding agent 的外掛、遙測、網路工具或套件下載是否連外,仍須另外檢查。
十、如果也想照做,我會先確認這份清單
- 先留足 SSD 空間:原始兩片 GGUF 就約 83.86GB,準備資料與 cache 還會增加占用;SSD 性能會直接影響讀取 experts 的代價。
- 別同時開兩份模型:獨立 API 與桌面載入擇一,先卸載再切換。
- Server/client 容量一致:服務 131072,agent 也要正確設定 context、input 與 output 預算,並保留 compaction。
- 先做小任務:先確認一般回覆、streaming、tool calling,再用一個檔案、一組測試逐步驗證,不直接放任 agent 改整個專案。
- 觀察整體時間:除了 tok/s,也看 prefill、首段正文等待、cache reuse、RAM、SSD 與排隊時間。
- 不要直接對外開放:本文服務只監聽
127.0.0.1且沒有 API 驗證;不能把占位字串當真正防護,更不應原樣暴露到 LAN/Internet。 - 參數以版本實測為準:workers、reserve、KV、MTP 與桌面欄位不能只憑名稱推定生效;改設定後重新載入並核對 log。
結論:RTX 4070 8GB+32GB RAM,確實能透過這份 Strata 配置提供 Qwen3.8-Flash-Next abliterated IQ3_S 的 128K 本機服務。代價是 SSD 讀取、記憶體壓力與等待;換來的是較長的開發脈絡,以及能自行掌握的本機模型後端。把它當成需要驗證、願意等一下的 coding 夥伴,比把它包裝成無條件的高速替代品,更接近真實使用方式。
參考來源與驗證邊界
- Strata GitHub:安裝、桌面/終端入口、API 與 coding-agent 整合。
- Qwen3.8-Flash-Next-GSQ-RCO-abliterated-GGUF:模型說明、IQ3_S 分片、授權與風險。模型頁標示原生 context 為 262144;本文只配置 131072,不將上游容量當作這台筆電的效能證明。
- 本機配置:
D:Stratastrata-iq3_s.json、兩個Start-Strata-*-128K.cmd與README-128K.md。 - 2026-10-31 歷史紀錄:
performance/TUNING-REPORT.md、stream-original-full.json、saved-config-final.json,以及既有 function-calling 驗證檔。 - 2026-11-01 本次確認:硬體、原始 GGUF 分片大小、現有啟動程序、
/health、/v1/models、/props、OpenCode 設定預覽,並擷取終端、Monitor 與原生桌面 Models 畫面。
未完成的驗證:從零填滿 128K 的壓力測試、不同 agent 的完整長任務品質比較、桌面載入後的推論、所有情境的最低吞吐量,以及上述專案新測試的生成與執行。本文 AI 生成配圖均另行標示,只有註明「實際截圖」的畫面才是執行證據。